Supabase — Datenbank, Anmeldung und KI-Gedächtnis auf dem eigenen Server
Tabellen, eine API ohne eigenen Server-Code, Konten mit Rechten pro Zeile, Dateien und ein Wissensspeicher, den eine KI durchsuchen kann. Alles in einer Postgres-Datenbank auf Deinem eigenen Server.
Worum geht's?
Wer eine kleine Anwendung baut, braucht fast immer dasselbe: eine Datenbank, eine Schnittstelle, Anmeldung, einen Ort für Dateien. Supabase liefert das in einem Paket, rund um PostgreSQL. In dieser Schulung betreibst Du es selbst und baust für die fiktive Nordwerk GmbH ein Backend mit Kundenanfragen, Teamkonten und Firmenwissen.
Der Kern ist Stufe 8: Die Zugriffsregeln stehen in der Datenbank, und wenn sie greifen, antwortet die API meist nicht mit einem Fehler, sondern mit einer leeren Liste. Stufe 6 zeigt vorher, was ohne Regeln passiert.
Danach wird die Datenbank zum Gedächtnis für eine KI: Firmentexte als Vektoren, eine Suche, die sechs von sechs Testfragen richtig zuordnet, und ein n8n-Ablauf, der mit Quellenangabe antwortet.
Selbstlern-Kurs zum Durchklicken. Dein Fortschritt wird lokal gespeichert.
? Für wen ist das interessant?
↗ Was Du vorher brauchst
- Einen Server mit SSH-Zugang und 4 GB RAM oder mehr: Self-Hosting & VPS, SSH.
- Docker mit Compose: Docker.
- Für die Stufen 10 und 11: LM Studio mit einem Embedding-Modell und n8n auf demselben Server.
📚 Die zwölf Stufen
ℹ Stand der Dinge
Aufgebaut und geprüft am 24. September 2026 mit dem offiziellen Docker-Stack self-hosted/v0.8.2 (PostgreSQL 17.6, pgvector 0.8.2, Studio vom 07.09.2026) auf einem VPS mit Ubuntu 24.04 LTS. Embeddings mit bge-m3 aus LM Studio, Antworten in n8n mit GLM 5.3 über das AuxData-Gateway.
Supabase entwickelt sich schnell, Beschriftungen im Studio ändern sich. Was bleibt, sind die Begriffe: Table Editor, SQL Editor, Policies, publishable und secret key, Bucket, RPC. Danach suchen, nicht nach dem genauen Wortlaut.
Was Supabase ist
Eine Postgres-Datenbank mit allem, was eine Anwendung drumherum braucht.
1 Postgres und sieben Dienste drumherum
Supabase ist keine eigene Datenbank. Im Kern läuft ein ganz normales PostgreSQL. Supabase stellt Dienste daneben, die man sonst einzeln einrichten müsste:
Das Wichtigste daran: Die Zugriffsregeln stehen in der Datenbank selbst (Row Level Security). Egal, ob eine Anfrage vom Browser, von n8n oder aus einem Skript kommt, Postgres prüft sie jedes Mal. Stufe 8 zeigt, warum das der Kern von Supabase ist.
2 Wann Supabase passt und wann nicht
| Du willst … | Passt Supabase? |
|---|---|
| Daten einer kleinen App oder eines Formulars ablegen, mit Konten und Rechten pro Zeile | Ja, genau dafür. |
| Firmenwissen für eine KI durchsuchbar machen, das mehrere Werkzeuge teilen | Ja, mit pgvector (Stufe 10 und 11). |
| Eine einzelne Liste für einen n8n-Ablauf | Nein, die Datentabellen von n8n reichen (n8n, Stufe 9). |
| Eine Anmeldung für viele Dienste im Unternehmen | Nein, dafür ist Keycloak gebaut. Supabase Auth verwaltet die Konten einer Anwendung. |
| Dokumente mit einer KI befragen, ohne selbst etwas zu bauen | Eher nicht. Open WebUI und LibreChat haben eine eingebaute Dokumentensuche mit eigenem Vektorspeicher. |
3 Was wir bauen
Die fiktive Nordwerk GmbH kennst Du vielleicht aus dem n8n-Kurs: ein kleiner Hersteller von Werkstattmöbeln. In dieser Schulung bekommt Nordwerk ein eigenes Backend:
- Eine Produktliste und eine Tabelle für Kundenanfragen (Stufe 4 und 5).
- Ein Kontaktformular darf Anfragen anlegen, aber nichts lesen. Nora und Paul aus dem Team sehen alle Anfragen und übernehmen sie (Stufe 6 bis 8).
- Fotos zu Reklamationen in einem privaten Bucket (Stufe 9).
- Das Firmenwissen als Vektoren, damit eine Frage wie „Wie lange dauert die Lieferung?“ den passenden Absatz findet (Stufe 10). n8n beantwortet damit Fragen mit Quellenangabe (Stufe 11).
Supabase gibt es als Cloud-Dienst (supabase.com) und zum Selbstbetreiben. Diese Schulung betreibt es selbst, auf Deinem Server. Die Oberfläche ist in beiden Fällen fast gleich, die Befehle zum Installieren und Sichern gelten nur für den eigenen Server.
✓ Kurz geprüft
Voraussetzungen und Sicherheit
Was vor dem ersten Befehl stehen muss, und drei Regeln, die Du nicht brechen solltest.
1 Deine Ausgangslage
- Ein Linux-Server mit SSH-Zugang und mindestens 4 GB RAM, besser 8. Die Übungsinstanz braucht mit allen elf Containern rund 1,4 GB im Leerlauf (gemessen am 24.09.2026). Wie Du einen Server mietest und absicherst: Self-Hosting & VPS und SSH.
- Docker mit Compose und Git auf diesem Server. Prüfen mit
docker compose versionundgit --version. Neu mit Containern? Dann zuerst die Docker-Schulung. - Für Stufe 10: Python 3.9 oder neuer auf Deinem Rechner und ein Embedding-Modell, zum Beispiel
text-embedding-bge-m3in LM Studio. - Für Stufe 11: ein n8n auf demselben Server, wie es der n8n-Kurs einrichtet, und ein Zugang zu einem Sprachmodell.
- Die Übungsdateien aus Befehle zum Kopieren: SQL für jede Stufe, Beispieldaten, das Einlese-Skript und den n8n-Ablauf.
2 Drei Regeln, bevor Du anfängst
127.0.0.1. Du erreichst sie über einen SSH-Tunnel. Docker umgeht dabei die Firewall des Servers: Ein Port, der in der Compose-Datei ohne 127.0.0.1 steht, ist von überall erreichbar, auch wenn UFW ihn sperrt..env.example enthält Beispielpasswörter und Beispielschlüssel, die jeder kennt. Stufe 3 erzeugt neue, bevor Supabase zum ersten Mal startet.sb_publishable_…) darf in eine Webseite, weil die Zugriffsregeln ihn begrenzen. Der geheime Schlüssel (sb_secret_…) umgeht alle Regeln. Er gehört nur auf Server, nie in einen Browser, ein Git-Repository oder einen Chat.sh reset.sh im Ordner /opt/supabase löscht Container und alle Daten der Übungsinstanz. Das Skript fragt vorher nach und bietet an, auch die .env zurückzusetzen. Danach kannst Du bei Stufe 3 neu anfangen.✓ Kurz geprüft
Installieren
Die offizielle Compose-Datei, eigene Schlüssel, alle Ports nur lokal. Auf dem Server, im Terminal.
1 Die Dateien holen
ls /opt/supabase zeigt unter anderem docker-compose.yml, .env, run.sh und den Ordner utils.git clone meldet einen Fehler? Die Versionsbezeichnung muss exakt stimmen. Welche aktuell ist, steht in der offiziellen Anleitung unter Self-Hosting with Docker.cd /opt git clone --depth 1 --branch self-hosted/v0.8.2 https://github.com/supabase/supabase supabase-src mkdir supabase && cp -rf supabase-src/docker/. supabase cd supabase cp .env.example .env printf 'ref=self-hosted/v0.8.2\n' > .supabase-version
self-hosted/v0.8.2, die aktuelle am 24.09.2026) statt des neuesten Stands. So entscheidest Du, wann sich etwas ändert.2 Alle Ports nur lokal
Die offizielle Datei öffnet die Ports 8000 (Studio und API), 5432 und 6543 (Datenbank) für alle Adressen. Statt sie zu ändern, legst Du eine kleine Zusatzdatei daneben. Supabase kennt dafür einen eigenen Mechanismus: Zusatzdateien heißen docker-compose.<name>.yml und werden mit sh run.sh config add <name> eingebunden.
# Alle Ports nur auf 127.0.0.1 (Zugriff per SSH-Tunnel).
# Docker umgeht die Firewall: ein Port ohne 127.0.0.1 wäre aus dem Internet erreichbar.
services:
api-gw:
ports: !override
- 127.0.0.1:8000:8000/tcp
supavisor:
ports: !override
- 127.0.0.1:5432:5432
- 127.0.0.1:6543:6543
!override ersetzt die Portliste der Originaldatei vollständig, statt Einträge anzuhängen. Beim Update der Originaldatei bleibt Deine Zusatzdatei unberührt.3 Eigene Schlüssel
sh run.sh config add lokal sh utils/generate-keys.sh --update-env sh utils/add-new-auth-keys.sh --update-env chmod 600 .env grep -c 'this_password_is_insecure' .env # muss 0 ergeben
.env. Ohne --update-env geben sie die Werte nur aus und schreiben nichts, das ist uns beim Aufbau passiert. Die letzte Zeile zählt, wie oft das Beispielpasswort noch in der Datei steht.4 Starten
sed -i 's/^ENABLE_EMAIL_AUTOCONFIRM=false/ENABLE_EMAIL_AUTOCONFIRM=true/' .env docker compose pull sh run.sh start docker compose ps
false..env enthält Deine eigenen Schlüssel.docker compose ps elf Container als healthy. Bei den Ports stehen nur Adressen mit 127.0.0.1.docker compose logs <name> lesen. Startet das API-Gateway nicht, hilft laut Anleitung oft ein neues Klonen: Die Dateien brauchen Linux-Zeilenenden.5 Der Tunnel und der erste Blick
ssh -N -L 8000:127.0.0.1:8000 root@DEIN-SERVER
http://localhost:8000. DEIN-SERVER steht für Adresse oder SSH-Alias.Der Browser fragt nach Benutzername und Passwort. Beides steht in der .env. Anzeigen lassen kannst Du es auf dem Server mit sh run.sh secrets.
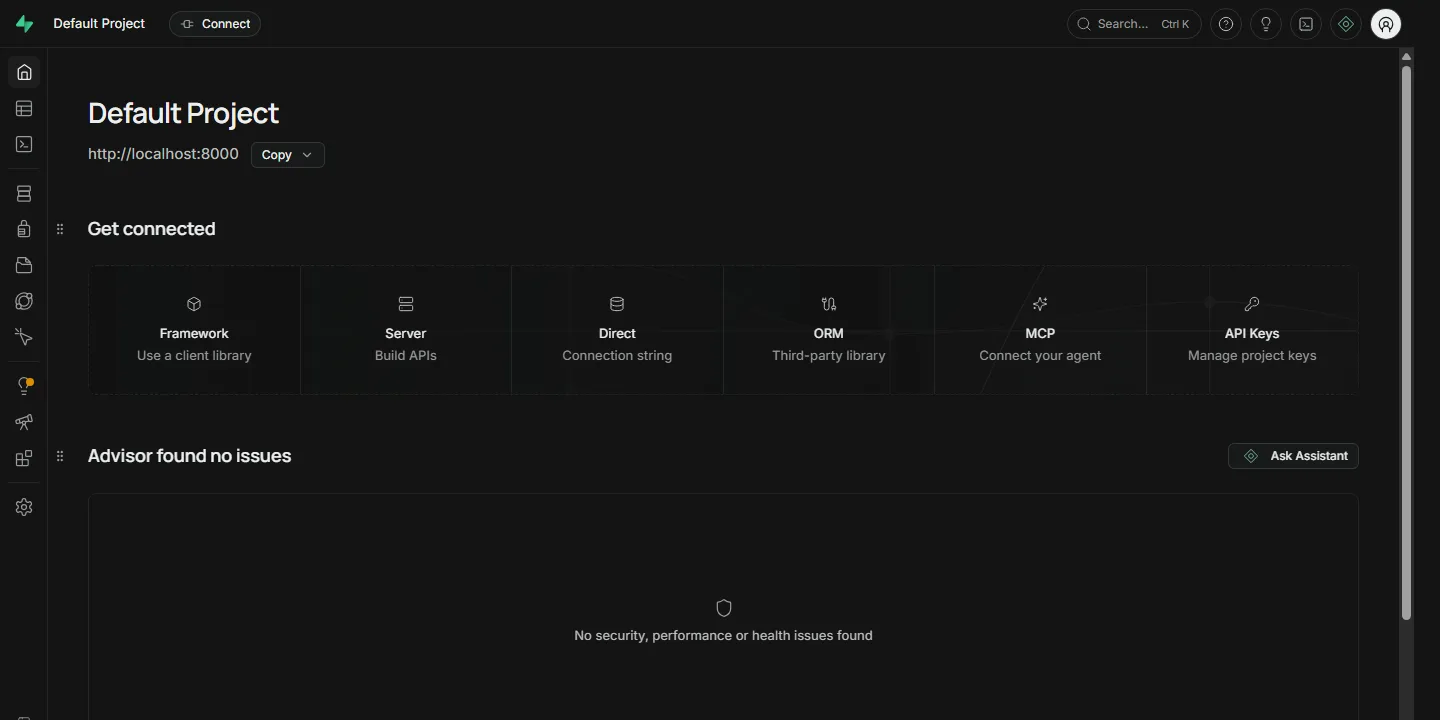
✓ Kurz geprüft
Studio und die erste Tabelle
Eine Produktliste per CSV-Import, ganz ohne SQL.
1 Tabelle anlegen
produkte. Den Haken bei Enable Row Level Security (RLS) gesetzt lassen.id und created_at.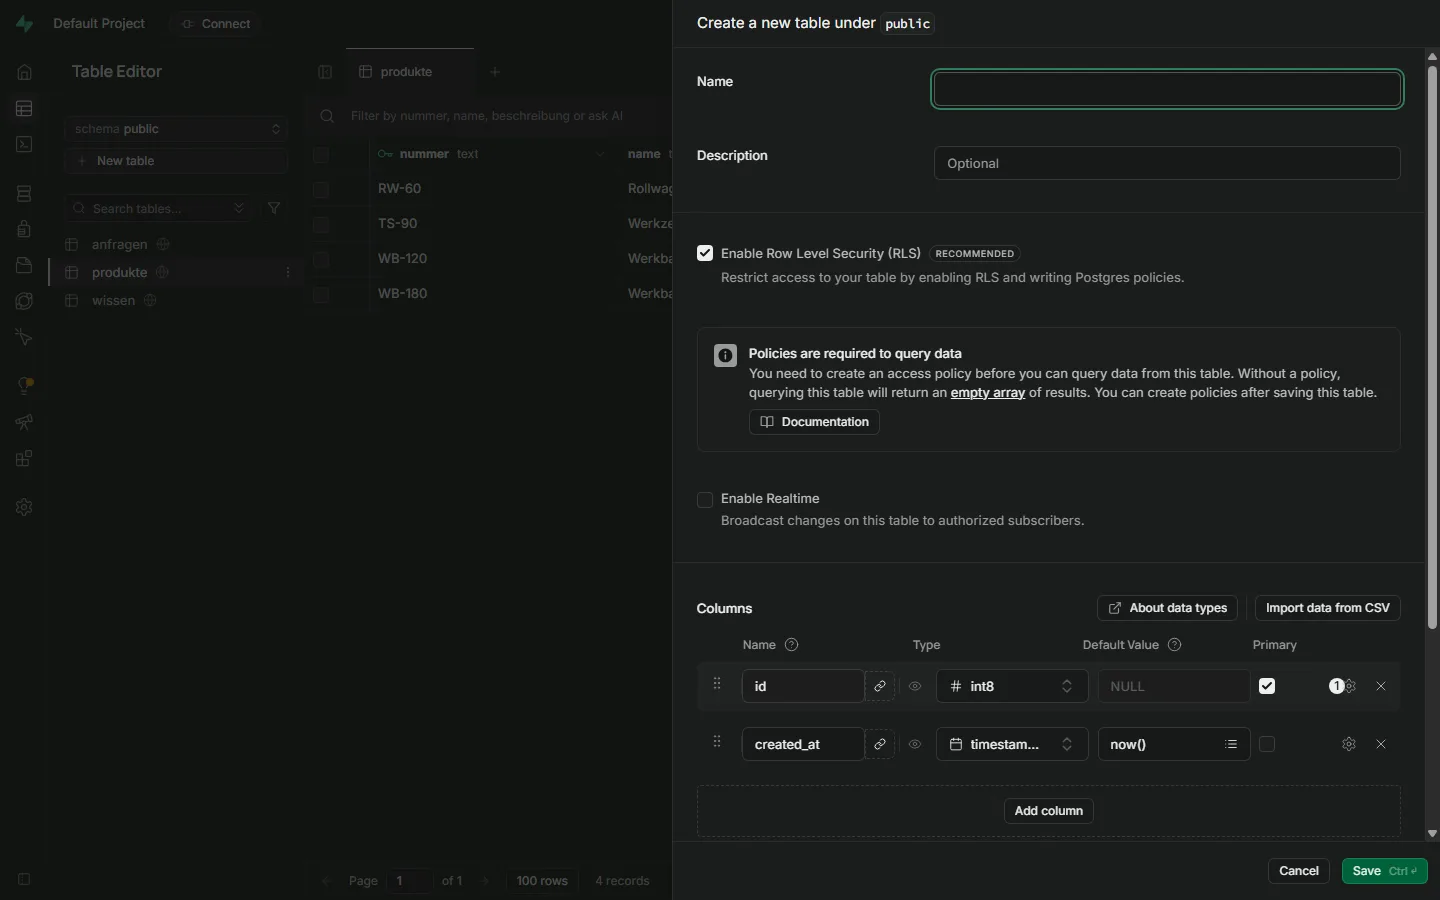
2 Daten aus einer CSV-Datei
nummer, name, beschreibung. Zurück im Formular ersetzen sie die beiden vorbereiteten Spalten.- und _ enthalten.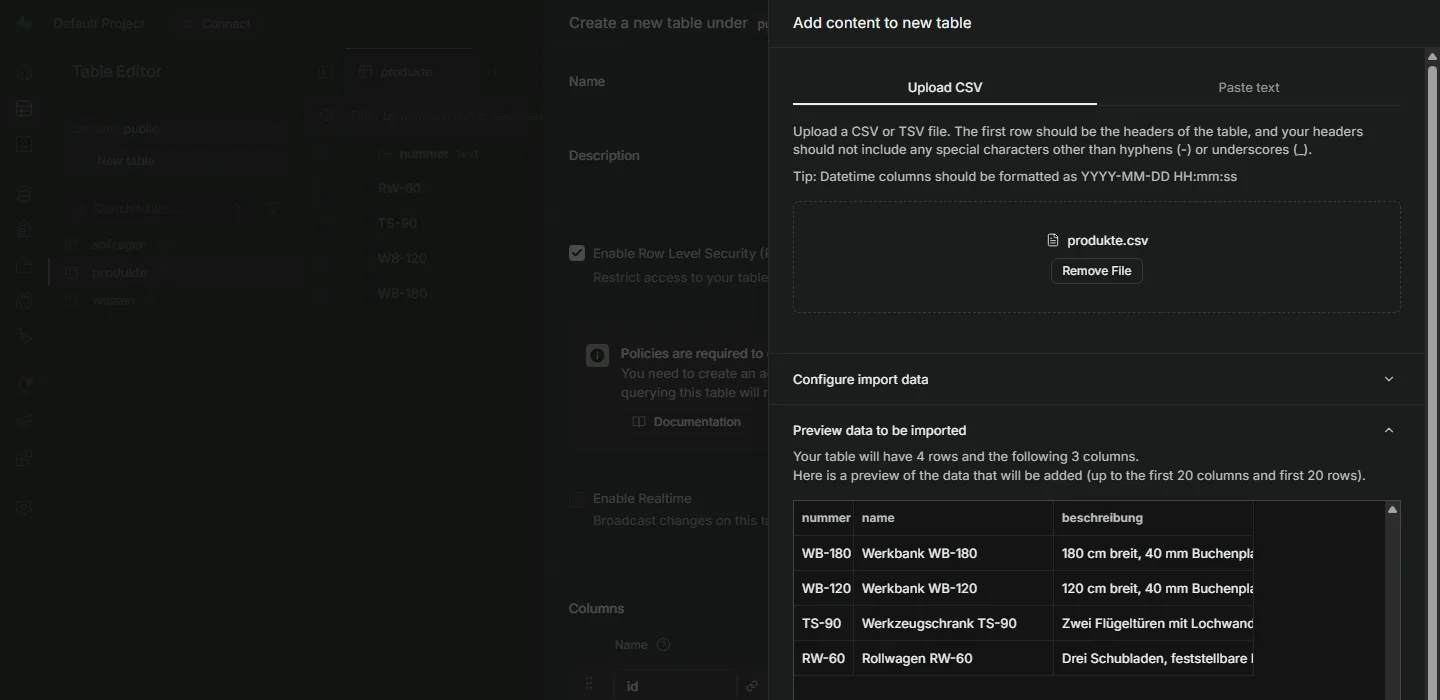
Jetzt meldet das Studio Warning: No primary keys selected. Ohne Primärschlüssel kann man Zeilen später nicht ändern oder löschen. Setze in der Zeile nummer den Haken bei Primary und speichere die Tabelle mit Save.
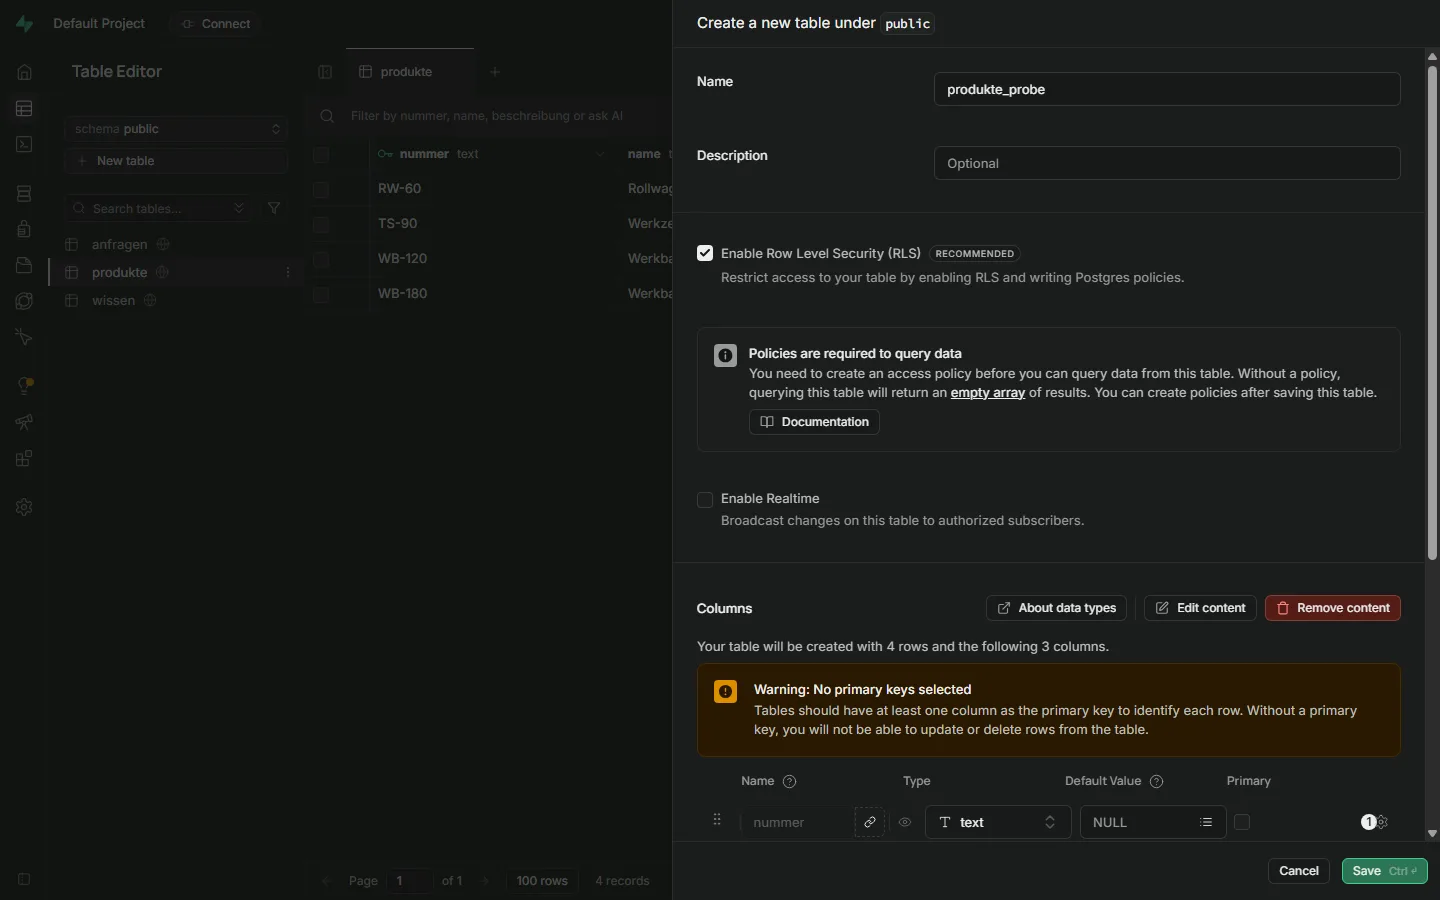
id braucht es nicht.✓ Kurz geprüft
SQL und Beziehungen
Die Anfragen-Tabelle als SQL: mit Pflichtfeldern, erlaubten Werten und einem Verweis auf die Produkte.
1 Warum SQL
Das Studio ist bequem, aber eine SQL-Datei kannst Du aufheben, weitergeben und auf einer zweiten Instanz genauso ausführen. Für alles, was Bestand haben soll, ist SQL der bessere Weg. Deshalb liegt jede weitere Stufe als SQL-Datei in demo/.
anfragen mit drei Beispielzeilen.produkte(nummer).-- Stufe 5 · Die Tabelle anfragen
-- Im Studio: SQL Editor → New query → einfügen → Run.
-- Setzt voraus, dass die Tabelle produkte aus Stufe 4 existiert.
create table public.anfragen (
id bigint generated always as identity primary key,
erstellt_am timestamptz not null default now(),
name text not null,
email text not null,
anliegen text not null,
produkt text references public.produkte (nummer),
kategorie text check (kategorie in ('Angebot', 'Support', 'Beschwerde', 'Sonstiges')),
status text not null default 'offen' check (status in ('offen', 'in Arbeit', 'erledigt')),
bearbeitet_von uuid references auth.users (id)
);
create index anfragen_status_idx on public.anfragen (status);
insert into public.anfragen (name, email, anliegen, produkt, kategorie) values
('Jana Weber', 'jana.weber@example.com', 'Was kostet die WB-180 mit Buchenplatte? Wir bräuchten drei Stück.', 'WB-180', 'Angebot'),
('Tim Brandt', 'tim.brandt@example.com', 'Die Tür am TS-90 schließt nicht mehr richtig.', 'TS-90', 'Support'),
('Eva Lorenz', 'eva.lorenz@example.com', 'Liefert ihr auch nach Österreich?', null, 'Sonstiges');
check lässt nur die genannten Werte zu, references nur Produktnummern, die es gibt. bearbeitet_von verweist auf die Nutzerkonten aus Stufe 7. Diese Regeln prüft die Datenbank bei jedem Schreiben, egal woher es kommt.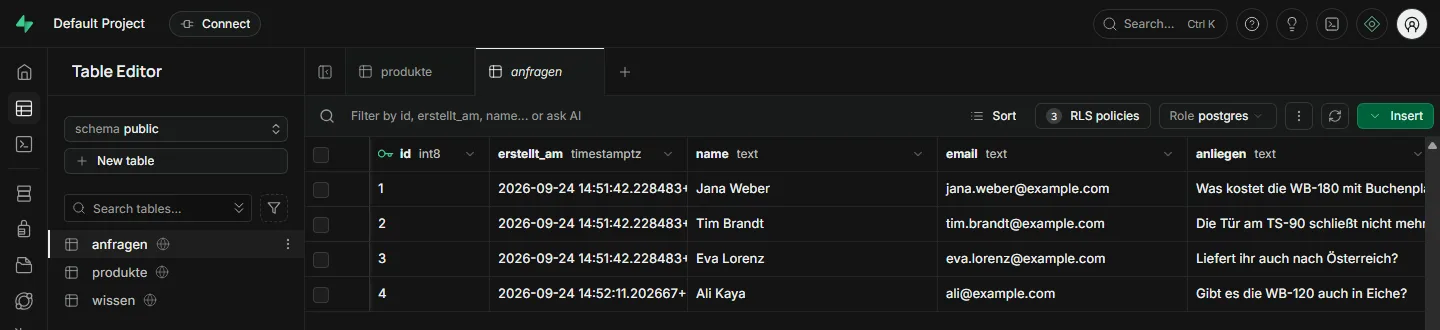
2 Eine Abweichung, die Du kennen solltest
create table nicht. anfragen ist in diesem Moment für jeden mit dem öffentlichen Schlüssel lesbar und änderbar. Das ist Absicht, damit Stufe 6 es zeigen kann. Stufe 8 schließt die Lücke.Unter Database → Policies bietet das Studio an, RLS für alle künftigen Tabellen automatisch einzuschalten (Automatically enable Row Level Security (RLS) on new tables → Set up trigger). Für eigene Projekte ist das eine gute Voreinstellung.
✓ Kurz geprüft
Die automatische API
Jede Tabelle ist sofort über HTTP erreichbar. Was das mit einer ungeschützten Tabelle bedeutet, zeigt diese Stufe.
1 Lesen mit dem öffentlichen Schlüssel
Die folgenden Befehle laufen auf dem Server. Sie tun genau das, was später eine Webseite mit dem öffentlichen Schlüssel tun kann.
cd /opt/supabase P=$(grep ^SUPABASE_PUBLISHABLE_KEY= .env | cut -d= -f2-) U=http://127.0.0.1:8000
curl -s "$U/rest/v1/produkte?select=nummer,name" -H "apikey: $P" curl -s "$U/rest/v1/anfragen?select=id,name,status" -H "apikey: $P"
[]
[{"id":1,"name":"Jana Weber","status":"offen"},
{"id":2,"name":"Tim Brandt","status":"offen"},
{"id":3,"name":"Eva Lorenz","status":"offen"}]
produkte hat RLS, aber noch keine Regel, also sieht niemand etwas, ohne Fehlermeldung. anfragen hat kein RLS, also sieht jeder alles, inklusive E-Mail-Adressen.2 Ändern ohne Anmeldung
curl -s -X PATCH "$U/rest/v1/anfragen?id=eq.3" -H "apikey: $P" \
-H "Content-Type: application/json" -H "Prefer: return=representation" \
-d '{"status":"erledigt"}'
"status":"erledigt". Mit derselben Methode ließe sich jede Zeile löschen. Setze den Status danach im Table Editor wieder auf offen.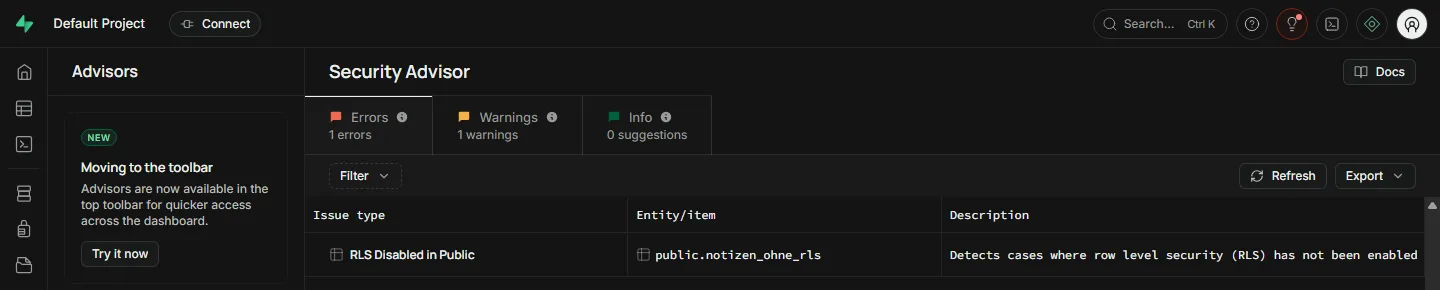
3 Die Adresse verrät die Abfrage
Filter und Spaltenauswahl stehen in der URL: ?select=id,name wählt Spalten, ?status=eq.offen filtert, ?order=erstellt_am.desc sortiert. Ohne apikey antwortet die API mit Unauthorized. Die Startadresse /rest/v1/ selbst antwortet dem öffentlichen Schlüssel mit 403. Das ist kein Defekt, die Liste aller Tabellen ist nur dem geheimen Schlüssel vorbehalten.
✓ Kurz geprüft
Anmeldung
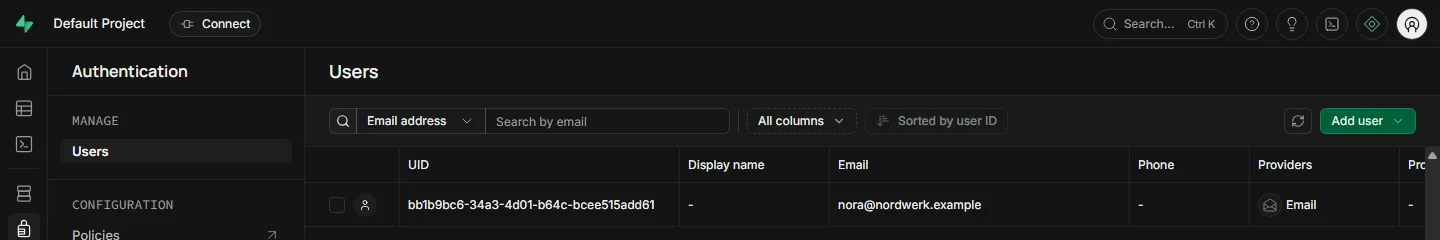
Nora bekommt ein Konto. Aus dem Konto wird ein Token, und das Token sagt der Datenbank, wer fragt.
1 Registrieren und anmelden
curl -s -X POST "$U/auth/v1/signup" -H "apikey: $P" -H "Content-Type: application/json" \
-d '{"email":"nora@nordwerk.example","password":"Werkbank-2026"}'
access_token, gültig 3600 Sekunden, und den Nutzer mit der Rolle authenticated. Ohne die Einstellung aus Stufe 3 käme stattdessen der Hinweis auf eine Bestätigungsmail.T=$(curl -s -X POST "$U/auth/v1/token?grant_type=password" -H "apikey: $P" \
-H "Content-Type: application/json" \
-d '{"email":"nora@nordwerk.example","password":"Werkbank-2026"}' | python3 -c "import json,sys; print(json.load(sys.stdin)['access_token'])")
echo "$T" | cut -c1-25
Lege auf dieselbe Weise einen Kollegen an: paul@nordwerk.example mit dem Passwort Hobelbank-2026. Stufe 8 braucht zwei Personen.
2 Was im Token steckt
Das Token ist ein signierter Ausweis (JWT). Er enthält Noras Nutzer-ID und die Rolle authenticated. Schickt eine Anfrage es im Kopf Authorization: Bearer … mit, weiß Postgres, wer fragt. In den Zugriffsregeln heißt die ID dann auth.uid(). Ohne Token ist die Rolle anon.
supabase-js: Anmeldung, Token merken, Token mitschicken, Token erneuern. Die curl-Befehle zeigen, was dabei unter der Haube passiert.✓ Kurz geprüft
Zugriffsregeln (RLS)
Das Formular darf anlegen, das Team darf lesen und übernehmen. Und die leisen Antworten, wenn eine Regel greift.
1 Die Regeln
anfragen, eine für produkte.drop policy "name" on public.anfragen; entfernen und neu anlegen.-- Stufe 8 · Row Level Security -- Ohne diese Datei darf jeder mit dem öffentlichen Schlüssel alle Anfragen lesen, ändern und löschen. alter table public.anfragen enable row level security; -- Das Kontaktformular (ohne Anmeldung) darf nur neue, offene Anfragen anlegen. Lesen darf es nichts. create policy "formular legt an" on public.anfragen for insert to anon with check (status = 'offen' and bearbeitet_von is null); -- Angemeldete Mitarbeitende sehen alle Anfragen ... create policy "team liest" on public.anfragen for select to authenticated using (true); -- ... übernehmen freie Anfragen und bearbeiten ihre eigenen. Eintragen dürfen sie dabei nur sich selbst. create policy "team bearbeitet" on public.anfragen for update to authenticated using (bearbeitet_von is null or bearbeitet_von = (select auth.uid())) with check (bearbeitet_von = (select auth.uid())); -- Die Produktliste ist öffentlich lesbar. create policy "alle lesen produkte" on public.produkte for select to anon, authenticated using (true);
using bestimmt, welche vorhandenen Zeilen eine Rolle sehen oder ändern darf. with check prüft, wie eine Zeile nach dem Schreiben aussehen muss. (select auth.uid()) in Klammern rechnet die Nutzer-ID einmal pro Abfrage statt einmal pro Zeile.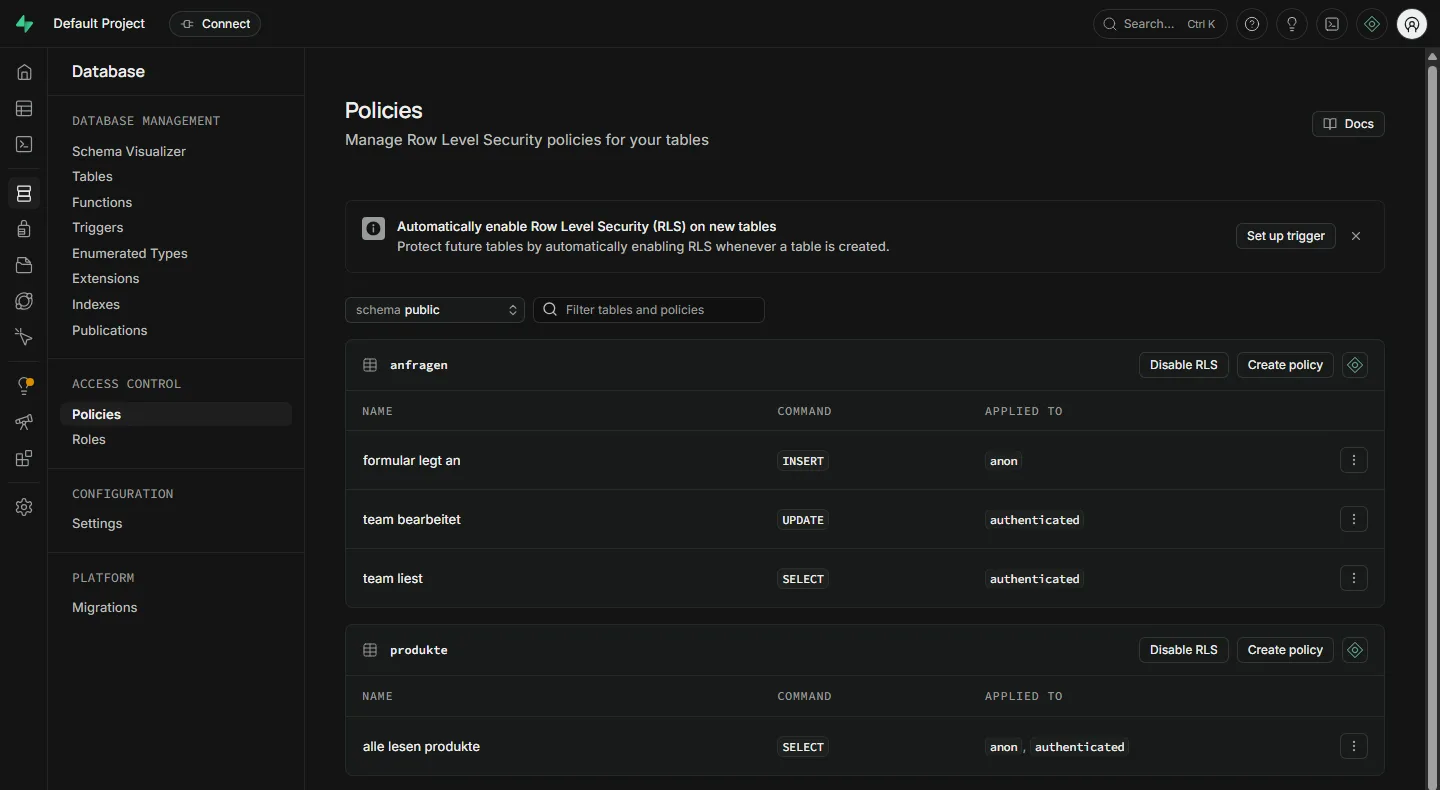
using (true)). Der Security Advisor meldete das als Warnung RLS Policy Always True. Die jetzige Fassung lässt nur freie oder eigene Anfragen zu.2 Jede Regel einmal ausprobieren
Gemessen am 24.09.2026. Die Tabelle zeigt, was die API bei welchem Versuch antwortet:
| Wer | Versuch | Antwort |
|---|---|---|
| ohne Anmeldung | Anfragen lesen | [], kein Fehler |
| ohne Anmeldung | Produkte lesen | alle vier Produkte |
| ohne Anmeldung | Anfrage 3 auf erledigt setzen | 200 und []: Nichts wurde geändert, aber es kommt keine Fehlermeldung |
| ohne Anmeldung | neue Anfrage mit Prefer: return=minimal | 201, angelegt |
| ohne Anmeldung | neue Anfrage mit return=representation | 401, new row violates row-level security policy, nichts angelegt |
| ohne Anmeldung | neue Anfrage mit Status erledigt | 401, abgelehnt |
| Nora | Anfragen lesen | alle Anfragen |
| Paul | freie Anfrage 2 übernehmen | 200, übernommen |
| Nora | Pauls Anfrage 2 ändern | 200 und [], nichts geändert |
| Nora | fremde Nutzer-ID eintragen | 403, abgelehnt |
| Nora | eine Anfrage löschen | 200 und []: Es gibt keine Löschregel, also wird nichts gelöscht |
# Das Kontaktformular legt eine Anfrage an (ohne Anmeldung)
curl -s -w "%{http_code}\n" -X POST "$U/rest/v1/anfragen" -H "apikey: $P" \
-H "Content-Type: application/json" -H "Prefer: return=minimal" \
-d '{"name":"Ali Kaya","email":"ali@example.com","anliegen":"Gibt es die WB-120 auch in Eiche?","produkt":"WB-120"}'
# Nora liest alle Anfragen (Token T aus Stufe 7)
curl -s "$U/rest/v1/anfragen?select=id,name,status" -H "apikey: $P" -H "Authorization: Bearer $T"
return=representation verlangen. Die neue Zeile zurückzugeben, wäre ein Lesezugriff, und den hat das Formular nicht. Dann scheitert das ganze Anlegen.✓ Kurz geprüft
Dateien ablegen
Ein privater Bucket für Fotos zu Reklamationen, geschützt mit denselben Regeln.
1 Bucket und Regeln
anhaenge, oben rechts Policies 2.-- Stufe 9 · Ein privater Bucket für Anhänge (Fotos zu Reklamationen)
-- Dasselbe geht im Studio unter Storage → New bucket; die Richtlinien stehen dort unter Policies.
insert into storage.buckets (id, name, public)
values ('anhaenge', 'anhaenge', false);
create policy "team lädt hoch" on storage.objects
for insert to authenticated
with check (bucket_id = 'anhaenge');
create policy "team liest anhänge" on storage.objects
for select to authenticated
using (bucket_id = 'anhaenge');
storage.objects. Deshalb gelten für sie dieselben Regeln wie für Deine Tabellen.2 Hochladen und abholen
printf "Foto der Tür am TS-90" > tuer.txt curl -s -X POST "$U/storage/v1/object/anhaenge/anfrage-2/tuer.txt" -H "apikey: $P" \ -H "Authorization: Bearer $T" -H "Content-Type: text/plain" --data-binary @tuer.txt
{"Key":"anhaenge/anfrage-2/tuer.txt", …}. Derselbe Befehl ohne Token wird mit new row violates row-level security policy abgelehnt.curl -s "$U/storage/v1/object/authenticated/anhaenge/anfrage-2/tuer.txt" -H "apikey: $P" -H "Authorization: Bearer $T"
curl -s -X POST "$U/storage/v1/object/sign/anhaenge/anfrage-2/tuer.txt" -H "apikey: $P" \
-H "Authorization: Bearer $T" -H "Content-Type: application/json" -d '{"expiresIn":60}'
signedURL, die 60 Sekunden lang ohne Anmeldung funktioniert. So gibst Du eine Datei gezielt weiter, ohne den Bucket zu öffnen.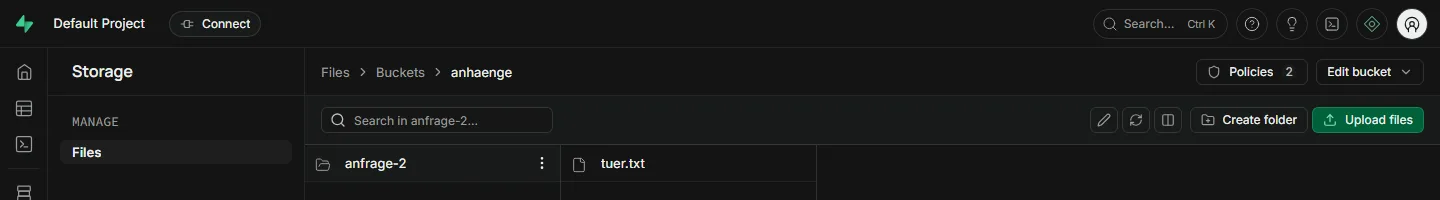
storage.sql./storage/v1/object/public/anhaenge/… antwortet bei einem privaten Bucket mit Bucket not found, obwohl es den Bucket gibt. Das ist gewollt: Nach außen verrät Supabase nicht, welche privaten Buckets existieren.volumes/functions/, erreichbar unter /functions/v1/<name>.✓ Kurz geprüft
Firmenwissen als Vektoren
Texte als Zahlenreihen speichern, damit eine Frage den passenden Absatz findet, auch mit anderen Worten.
1 Was ein Vektor hier ist
Ein Embedding-Modell macht aus einem Text eine lange Reihe von Zahlen, bei bge-m3 sind es 1024. Texte mit ähnlicher Bedeutung bekommen ähnliche Zahlenreihen. „Wie lange dauert es, bis meine Werkbank da ist?“ landet so nahe bei „Die Lieferzeit beträgt zwei bis drei Wochen“, obwohl kein Wort gleich ist. pgvector speichert solche Reihen in Postgres und findet die ähnlichsten.
-- Stufe 10 · Firmenwissen als Vektoren
-- 1024 Werte passen zu bge-m3 (LM Studio: text-embedding-bge-m3). Ein anderes Modell braucht
-- eine andere Zahl, und alte Vektoren müssen neu berechnet werden.
create extension if not exists vector with schema extensions;
create table public.wissen (
id bigint generated always as identity primary key,
quelle text not null,
inhalt text not null,
embedding extensions.vector(1024) not null
);
create index wissen_embedding_idx on public.wissen
using hnsw (embedding extensions.vector_cosine_ops);
alter table public.wissen enable row level security;
create policy "team liest wissen" on public.wissen
for select to authenticated
using (true);
-- Sucht die Abschnitte, die einer Frage am ähnlichsten sind.
-- aehnlichkeit: 1 = gleiche Bedeutung, 0 = nichts gemeinsam.
create or replace function public.match_wissen (
frage extensions.vector(1024),
anzahl int default 3,
mindestens float default 0.5
)
returns table (id bigint, quelle text, inhalt text, aehnlichkeit float)
language sql stable
set search_path = ''
as $$
select w.id, w.quelle, w.inhalt,
1 - (w.embedding operator(extensions.<=>) frage) as aehnlichkeit
from public.wissen w
where 1 - (w.embedding operator(extensions.<=>) frage) >= mindestens
order by w.embedding operator(extensions.<=>) frage
limit anzahl;
$$;
vector(1024) muss zum Modell passen. Der Index hnsw hält die Suche auch bei vielen tausend Abschnitten schnell. match_wissen gibt nur Treffer ab einer Mindestähnlichkeit zurück, damit eine Frage ohne passende Antwort auch keine bekommt.2 Einlesen von Deinem Rechner
vektor.sql ist ausgeführt, der Tunnel aus Stufe 3 läuft, LM Studio hat text-embedding-bge-m3 geladen und den Server gestartet.wissen_einlesen.py und der Ordner wissen/). In PowerShell die Zeilen unten, den geheimen Schlüssel aus der .env auf dem Server einsetzen.$env:SUPABASE_URL = "http://localhost:8000" $env:SUPABASE_SECRET_KEY = "sb_secret_…" # aus /opt/supabase/.env $env:EMBED_URL = "http://localhost:1234/v1" # LM Studio $env:EMBED_MODEL = "text-embedding-bge-m3" python wissen_einlesen.py
--leeren löscht es vorher alle Abschnitte, sonst hängt es an. Den geheimen Schlüssel braucht es, weil die Tabelle wissen keine Schreibregel hat: Einlesen ist Sache des Betreibers, nicht der Nutzer.Statt LM Studio geht jede Schnittstelle, die /v1/embeddings im OpenAI-Format anbietet und bge-m3 liefert, zum Beispiel das AuxData-Gateway mit EMBED_URL=https://auxdata.ai/v1, EMBED_MODEL=bge-m3 und Deinem Schlüssel in EMBED_KEY. Gemessen am 24.09.2026: Die Vektoren beider Quellen stimmen zu 99,94 % überein, Du kannst sie mischen.
3 Suchen, und warum das Modell zählt
Sechs Testfragen aus fragen.txt, als Nora über die API gegen match_wissen gestellt. So sah das Ergebnis aus:
| Frage | bester Treffer | Ähnlichkeit |
|---|---|---|
| Wie lange dauert es, bis meine Werkbank da ist? | lieferung.md: Spedition, zwei bis drei Wochen | 0,564 |
| Mein Schrank ist beschädigt angekommen, was muss ich tun? | garantie.md: Fotos und Rechnungsnummer schicken | 0,516 |
| Wie viel Gewicht hält die Werkbank aus? | produkte.md: WB-180 trägt 500 kg | 0,740 |
| Kommt ihr auch zum Aufbauen nach München? | lieferung.md: Aufbau im Umkreis von 150 km | 0,590 |
| Wie pflege ich die Holzplatte? | pflege.md: Arbeitsplattenöl | 0,637 |
| Ist der Schrank abschließbar? | produkte.md: TS-90, abschließbar | 0,548 |
| Was kostet ein Rollwagen? | kein Treffer über 0,5 | – |
Sechs von sechs richtig, und die Preisfrage, zu der das Firmenwissen nichts sagt, bekommt bewusst keinen Treffer. Ohne Anmeldung liefert die Suche [], weil wissen nur für das Team lesbar ist.
gte-small, 384 Werte). Mit denselben Texten traf es nur drei von sechs Fragen, und alle Ähnlichkeiten lagen zwischen 0,85 und 0,89, richtige wie falsche. Das Modell ist auf Englisch trainiert. Für deutsche Texte braucht es ein mehrsprachiges Modell wie bge-m3.✓ Kurz geprüft
n8n anbinden
Ein Formular nimmt eine Frage an, n8n sucht im Firmenwissen und lässt ein Sprachmodell mit Quellenangabe antworten.
1 n8n ins Supabase-Netz
n8n und Supabase laufen auf demselben Server, aber in getrennten Docker-Netzen. Über localhost erreicht n8n Supabase nicht: localhost ist im Container der Container selbst. Die Lösung ist ein gemeinsames Netz. Dann heißt die Adresse http://api-gw:8000, nach dem Namen des Gateways in der Supabase-Compose-Datei.
services:
n8n:
# … wie bisher …
networks: [default, supabase]
networks:
supabase:
external: true
name: supabase_default
supabase_default ist das Netz, das Supabase beim Start anlegt. Supabase muss also zuerst laufen. Beim Anhalten von Supabase meldet Compose danach Network supabase_default Resource is still in use. Das ist harmlos: n8n hängt noch darin.2 Der Zugang und der Ablauf
http://api-gw:8000, Service Role Secret = Dein geheimer Schlüssel. Dann einen neuen Workflow öffnen und den Inhalt von n8n-wissenssuche.json mit Strg+V einfügen. In den Knoten Frage in Vektor, Wissen suchen und GLM über AuxData jeweils den passenden Zugang auswählen.- Frage stellen: ein Formular, nur für angemeldete n8n-Nutzer.
- Frage in Vektor: ruft
/v1/embeddingsmit dem Modellbge-m3auf. Es muss dasselbe Modell sein wie beim Einlesen. - Wissen suchen: ruft
/rest/v1/rpc/match_wissenauf. Jede SQL-Funktion ist unter/rpc/<name>erreichbar. - Fundstellen bündeln: nummeriert die Treffer, damit das Modell sie zitieren kann. Always Output Data am Suchknoten sorgt dafür, dass es auch ohne Treffer weitergeht.
- Antwort schreiben: das Modell darf nur die Abschnitte benutzen und muss sie in eckigen Klammern nennen. Ohne Treffer gibt es keine Antwort vom Modell, sondern die Seite Nichts gefunden.
Beim Aufbau durchgespielt, mit n8n 2.40.5 und GLM 5.3. Auf die Frage „Wie lange dauert es, bis meine Werkbank da ist?“ zeigte die Antwortseite nach rund drei Sekunden:
Quellen: lieferung.md, produkte.md, garantie.md
„Was kostet ein Rollwagen?“ führte zur Seite Nichts gefunden, ohne dass das Sprachmodell überhaupt gefragt wurde. Die Quellenliste nennt alle Treffer über der Mindestähnlichkeit; welcher davon die Antwort trägt, zeigt die Nummer in eckigen Klammern.
3 Andere Wege
- Docling zerlegt PDFs in sauberen Text (Docling-Kurs). Dessen Markdown in den Ordner
wissen/gelegt, liestwissen_einlesen.pyHandbücher und Produktblätter genauso ein. - Der Knoten „Supabase Vector Store“ in n8n erledigt Einlesen und Suchen in einem, erwartet aber eine Tabelle und Funktion nach den Namensregeln von LangChain (
documents,match_documents). Der Weg über HTTP-Aufrufe zeigt, was passiert, und passt zu jeder eigenen Tabelle. - Claude Code oder Codex schreiben Dir eine kleine Web-App gegen dieselbe API, mit
supabase-jsund dem öffentlichen Schlüssel. Die Regeln aus Stufe 8 schützen die Daten dann auch vor Fehlern im erzeugten Code.
✓ Kurz geprüft
Sichern und Betrieb
Zwei Arten von Sicherung, ein Rückweg, der wirklich ausprobiert wurde, und was im Alltag zählt.
1 Zwei Arten zu sichern
#!/bin/sh
# backup.sh — sichert die Supabase-Übungsinstanz in /opt/supabase/backups/<Zeitpunkt>/
#
# sh backup.sh # im laufenden Betrieb: Dump Deiner Tabellen (Schema public)
# sh backup.sh --komplett # hält Supabase kurz an und sichert alles: Datenbankdateien,
# # Storage-Dateien, Funktionen, .env und das Volume db-config
#
# Der Dump reicht, um eine versehentlich gelöschte Tabelle zurückzuholen.
# Vor einem Update braucht es die komplette Sicherung, sonst gibt es keinen Rückweg.
set -eu
cd /opt/supabase
ZIEL="backups/$(date +%Y-%m-%d-%H%M)"
mkdir -p "$ZIEL"
docker exec supabase-db pg_dump -U postgres -d postgres -n public -Fc > "$ZIEL/public.dump"
echo "Dump: $ZIEL/public.dump ($(du -h "$ZIEL/public.dump" | cut -f1))"
if [ "${1:-}" = "--komplett" ]; then
sh run.sh stop
tar czf "$ZIEL/volumes.tar.gz" volumes
docker run --rm -v supabase_db-config:/quelle:ro -v "$PWD/$ZIEL":/ziel alpine \
tar czf /ziel/db-config.tar.gz -C /quelle .
cp .env "$ZIEL/env.sicherung"
sh run.sh start
echo "Komplett: $ZIEL ($(du -sh "$ZIEL" | cut -f1))"
fi
chmod -R go-rwx backups
public. Die komplette Sicherung hält Supabase an und packt alles ein: Datenbankdateien, Dateiablage, Funktionen, die .env und das Volume db-config, das interne Schlüssel der Datenbank enthält. Beim Aufbau: 9,3 MB, Supabase war 55 Sekunden weg.2 Eine Tabelle zurückholen
D=backups/2026-09-24-1500 # Deine Sicherung docker exec -i supabase-db pg_restore -U postgres -d postgres --data-only -t wissen < $D/public.dump
delete from wissen, dann dieser Befehl, danach waren alle sieben Abschnitte samt Vektoren wieder da.3 Der Rückweg für alles
cd /opt/supabase D=backups/2026-09-24-1500 sh run.sh stop mv volumes volumes.vorher tar xzf $D/volumes.tar.gz docker run --rm -v supabase_db-config:/ziel -v "$PWD/$D":/quelle:ro alpine \ sh -c "rm -rf /ziel/* && tar xzf /quelle/db-config.tar.gz -C /ziel" sh run.sh start
volumes.vorher löschst Du erst, wenn alles läuft.update.sh mit. Wir haben es in dieser Schulung nicht ausprobiert. Welche Version aktuell ist und was sich ändert, steht in der CHANGELOG.md und in der offiziellen Anleitung. Ohne komplette Sicherung gibt es keinen Rückweg: Die Datenbank wird beim Start einer neuen Version umgebaut.4 Im Alltag
docker stats --no-stream --format "{{.Name}} {{.MemUsage}}" | grep supabase
docker compose logs --since 24h | grep -i error | tail
du -sh backups/*
- Sicherungen weg vom Server:
scp -r root@DEIN-SERVER:/opt/supabase/backups ./supabase-sicherungen. Eine Sicherung auf derselben Platte hilft nicht, wenn der Server verloren geht. - Security Advisor nach jeder Änderung an Tabellen oder Regeln öffnen und Rerun linter.
- Mailversand einrichten, bevor echte Menschen sich registrieren, und die automatische Bestätigung wieder abschalten.
- Öffentlich erreichbar wird die API erst mit Domain, HTTPS und Reverse Proxy (Self-Hosting). Das Studio bleibt auch dann besser hinter dem Tunnel.
✓ Kurz geprüft
Befehle zum Kopieren
Alles aus den zwölf Stufen an einer Stelle, dazu die Übungsdateien.
1 Übungsdateien
- produkte.csv: Produktliste für Stufe 4
- schema.sql: Tabelle anfragen, Stufe 5
- rls.sql: Zugriffsregeln, Stufe 8
- storage.sql: Bucket und Regeln, Stufe 9
- vektor.sql: pgvector, Tabelle wissen, Suchfunktion, Stufe 10
- wissen_einlesen.py: Einlese-Skript, Stufe 10
- fragen.txt: sechs Testfragen, Stufe 10
- n8n-wissenssuche.json: n8n-Ablauf, Stufe 11
- backup.sh: Sicherung, Stufe 12
- Ordner
wissen/: produkte.md, lieferung.md, garantie.md, pflege.md
2 Installation
cd /opt
git clone --depth 1 --branch self-hosted/v0.8.2 https://github.com/supabase/supabase supabase-src
mkdir supabase && cp -rf supabase-src/docker/. supabase
cd supabase
cp .env.example .env
printf 'ref=self-hosted/v0.8.2\n' > .supabase-version
# Alle Ports nur auf 127.0.0.1 (Zugriff per SSH-Tunnel).
# Docker umgeht die Firewall: ein Port ohne 127.0.0.1 wäre aus dem Internet erreichbar.
services:
  api-gw:
    ports: !override
      - 127.0.0.1:8000:8000/tcp
  supavisor:
    ports: !override
      - 127.0.0.1:5432:5432
      - 127.0.0.1:6543:6543
sh run.sh config add lokal
sh utils/generate-keys.sh --update-env
sh utils/add-new-auth-keys.sh --update-env
chmod 600 .env
grep -c 'this_password_is_insecure' .env      # muss 0 ergeben
sed -i 's/^ENABLE_EMAIL_AUTOCONFIRM=false/ENABLE_EMAIL_AUTOCONFIRM=true/' .env
docker compose pull
sh run.sh start
docker compose ps
ssh -N -L 8000:127.0.0.1:8000 root@DEIN-SERVER
3 Im Betrieb
cd /opt/supabase
P=$(grep ^SUPABASE_PUBLISHABLE_KEY= .env | cut -d= -f2-)
U=http://127.0.0.1:8000
services:
n8n:
# … wie bisher …
networks: [default, supabase]
networks:
supabase:
external: true
name: supabase_default
$env:SUPABASE_URL = "http://localhost:8000"
$env:SUPABASE_SECRET_KEY = "sb_secret_…"          # aus /opt/supabase/.env
$env:EMBED_URL = "http://localhost:1234/v1"       # LM Studio
$env:EMBED_MODEL = "text-embedding-bge-m3"
python wissen_einlesen.py
cd /opt/supabase && sh reset.sh
backups/ bleiben liegen.4 Weiterlesen
- Self-Hosting with Docker: offizielle Anleitung, aktuelle Version
- Row Level Security: alle Möglichkeiten der Regeln
- pgvector: Indizes, Abstandsmaße, Grenzen
- n8n · Docling · LM Studio · Docker · Self-Hosting
Quiz
7 Fragen quer durch die Stufen. Ab 6 richtigen Antworten schaltest du dein Zertifikat frei.
Dein Zertifikat
Glückwunsch! Trage deinen Namen ein und drucke das Zertifikat (oder speichere als PDF).